1.线性代数:向量、点积与线性变换
配套视频
B站 · 3B1B《线性代数的本质》全 16 集 —— 对应本篇章节 1~4 集(向量 / 线性组合 / 矩阵即变换)和第 9 集(点积)
官网 · 3B1B 官网 · 线性代数专题 —— 每集配套文字稿,可当英文复习材料
MIT · MIT 18.06 线性代数(Gilbert Strang) —— 想要系统课堂版就看这个,B 站有中英字幕搬运
讲义 · 斯坦福 CS229 线性代数复习讲义(PDF) —— 把线代和机器学习挂钩,篇幅密度高
重点
向量 = 一组有序数字,在大模型里代表"一个词 / 一个 token 的意思"
点积 = 相似度——这一条直接支撑了注意力机制和向量检索(RAG)
矩阵 = 线性变换,"把向量变成另一个向量";模型的一层就是一次变换
矩阵乘法 = 复合变换,先 A 后 B 等于一次性做 BA
大模型里到处都是矩阵:embedding 表、QKV 投影、输出层、LoRA 增量
1.1 向量:从"箭头"到"词的意思"
几何视角:空间里一带箭头的线段,方向 + 长度
坐标视角:一列数
[3, 4],可以直接参与运算
大模型用的是坐标视角,但意义来自几何视角——两个向量的"几何接近"就是"语义相似"。
💎 大模型里的向量:GPT 把每个 token 变成一个 d_model 维向量(Llama-3-8B 是 4096 维)。"猫"和"小猫"的向量在 4096 维空间里距离很近,"猫"和"汽车"离得很远。这就是词嵌入(embedding)。
1.2 点积:大模型最核心的一个运算
两个向量的点积,对应元素相乘再求和:
点积的代数定义
几何上,它等于"一个向量在另一个上的投影长度 × 另一个的长度":
点积的几何定义
两边同时除以 ,就得到余弦相似度——这正是 RAG 向量检索和注意力机制的数学基础:
余弦相似度
⭐ 点积在大模型里的两个用武之地
① 注意力机制: 就是"每个 query 和每个 key 做点积",点积大 = 这个 token 该关注那个 token; ② 向量检索(RAG):把问题编码成向量,和知识库里所有向量做点积,取最大的几条作为参考资料。
1.3 范数:向量的"长度"
最常用的是 L2 范数(欧氏长度):
L2 范数
L2 范数:深度学习里用于权重正则化(weight decay),防止权重过大
L1 范数:绝对值之和,倾向于产生稀疏解
归一化:把向量除以自己的范数,得到单位向量——这样点积就等于余弦相似度了
1.4 矩阵乘法:一次"线性变换"
矩阵 A(m×n)乘向量 x(n×1)得到 y(m×1),理解为"A 把 x 变换成 y":
线性变换(神经网络一层的核心)
W:权重矩阵 b:偏置向量
所有"保持直线仍是直线、原点不动"的变换都叫线性变换:旋转、缩放、剪切、投影。
1.5 转置 / 逆 / 行列式 / 秩(速览)
⚠️ 秩(rank)要特别记住:一个 m×n 矩阵的秩最多是 min(m,n)。如果一个 4096×4096 矩阵的精确秩是 8,它可以精确写成 4096×8 与 8×4096 两个矩阵的乘积;如果只是有效秩约为 8,则只能近似表示。LoRA 使用同样的低秩参数化,但假设低秩的是微调增量,而不是原权重。
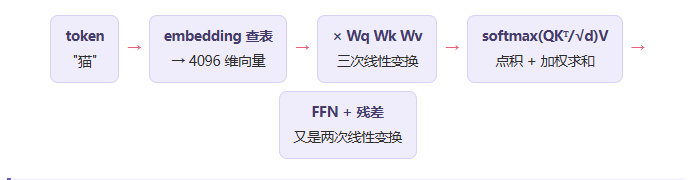
1.6 在大模型里的完整链路
把上面所有概念串起来,一个 Transformer 层做的事就是:
用 NumPy 亲手验证"点积 = 相似度"
import numpy as np

# 假设我们已经有了 4 个词的 3 维 embedding(真实模型是 4096 维)
emb = {
    "猫":    np.array([0.9,  0.8,  0.1]),
    "小猫":  np.array([0.85, 0.75, 0.15]),
    "狗":    np.array([0.88, 0.70, 0.20]),
    "汽车":  np.array([0.05, 0.15, 0.95]),
}

def cos_sim(a, b):
    # 余弦相似度 = 点积 / (模长 × 模长)
    return (a @ b) / (np.linalg.norm(a) * np.linalg.norm(b))

base = "猫"
for w in emb:
    if w == base: continue
    print(f"{base} vs {w}: {cos_sim(emb[base], emb[w]):.4f}")

# 输出(余弦相似度,越接近 1 越像):
#   猫 vs 小猫: 0.9997   ← 极像
#   猫 vs 狗:   0.9959   ← 很像(都是动物)
#   猫 vs 汽车: 0.1496   ← 完全不像

# 这就是 RAG 检索的全部原理:把 query 和所有文档向量算余弦相似度,取 top-k。
# 也是注意力机制的雏形:query 和每个 key 算相似度,再用来加权 value。
评论区